


中国GPU企業「壁仞科技(Birentech)」、約40億円の大口案件を獲得
このほど、「昆侖領奕智算センタープロジェクト(第一期)」の見積比較方式による調達結果が正式に公表された。上海壁仞科技股份有限公司は、1億7400万元(約40.02億円)で大口案件を獲得した。
同プロジェクトの調達予算総額は約6億2600万元(約143.98億円)で、案件は内容ごとに2つのロットに分割して発注された。第1ロットの予算は約1億7400万元(約40.02億円)、第2ロットは約4億5200万元(約103.96億円)。壁仞科技は審査で89.71点を得て総合順位でトップとなり、第1ロットの受注を決めた。契約締結後は45日以内に納入を完了することが求められている。
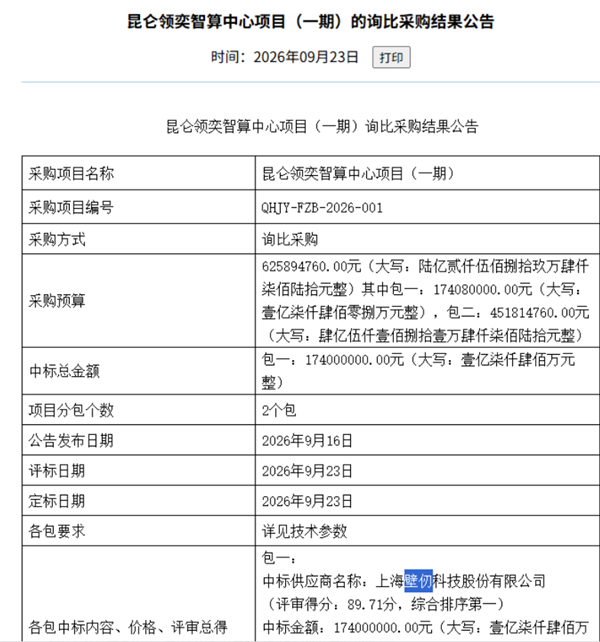
注目されるのは、第2ロットについて、提案書を提出した事業者が3社に満たなかったため、入札不落として扱われた点だ。予算額が4億5000万元を超える発注区分でありながら、参加企業数の不足によって成立しなかったことは、現在の中国国産AI計算力サプライチェーンにおける供給先の集中度の高さと、製品・供給能力の希少性をしている。
今回、壁仞科技が受注した中核製品は「壁砺」シリーズのGPUだ。公開資料によれば、壁砺GPUは伝統的なGPGPUアーキテクチャを採用し、中核演算ユニットであるSPCストリームプロセッサーに、専用のテンソル演算ユニット「T-Core」を統合している。現在、同社はBR106、BR110、BR166の3世代にわたる製品ラインアップを構築している。BR106は2023年に量産を開始しており、BR166はチップレット設計を採用し、BR110はエッジおよびクラウドでの推論用途を想定した製品とされる。次世代の主力学習・推論向けチップ「BR20X」は2026年の市場投入を目標としており、FP8やFP4などのデータ形式に対応し、より大容量のメモリーと高帯域の相互接続を備える計画だ。
また、壁仞科技は独自開発の「BLink」プロトコルにより、GPUカード間のダイレクト接続を実現している。単一チャネル当たりの双方向帯域は最大64GB/sで、最大8枚のGPUによるポイントツーポイントのダイレクト接続を構成できる。Scale-outの段階では、OCS(光回線スイッチング)方式を採用しており、2025年末時点で2048枚のGPUを光インターコネクトで接続した光スイッチ型GPUスーパーノード・クラスターの納入に成功しており、1000枚規模のGPUクラスターでは、線形加速比95%を達成したとしている。
ソフトウェア・エコシステムの面では、壁仞科技は主要な大規模言語モデルに対してDay 0レベルの対応能力を備えており、智譜(Zhipu)GLM、DeepSeek、アリババQwen、月之暗面(Moonshot AI)Kimiといった中国の主要モデルベンダーをカバーしている。また、同社の「BIRENSUPA」ソフトウェアプラットフォームは、PyTorch、TensorFlow、飛桨(PaddlePaddle)などの主要フレームワークに加え、vLLMなどの推論フレームワークにも対応している。
(為替換算レート:1人民元=23円で計算)
(原文:https://www.icsmart.cn/142519/)